扫描 PDF 转 LaTeX 的完整流程与常见失败
更新于
扫描 PDF 转 LaTeX面对的是已经被拍成页面的内容,字符与数学结构要从图像中重新取得。开始前先看扫描质量是否足以支持核对,再安排校正、分区、逐条识别和合并。模糊或被裁断的信息不能靠一段能显示的代码证明已经恢复。
先挑难页评估,再处理整份资料
从文件中选一页含小下标、长分式或密集版面的页面,放大查看最细笔画。记录哪里模糊、哪里倾斜、哪里有明显墨点,以及是否存在被页边裁断的表达。若第一轮就发现细节不可辨,应先寻找更清晰材料,不要立即给所有页面做同样处理。
能回到纸本时,可调整摆放与扫描细节重新取得;只有现有文件时,保留原始副本,再尝试有限的图像修整。重采集与拉大旧图不同,后者不会补出原先没有记录的笔画。根据评估把页面分成可直接处理、需要修整和待回查三类,后续工作才不会被同一类失败反复打断。
校正方向后,按正文关系划分区域
先在图像处理环节摆正页面,确认旋转后没有裁掉四角内容,再检查局部弯曲是否仍明显。随后清理可确认的背景干扰,但保护小数点、导数撇号与细横线。每一步保留对照版本,避免清理过程引入的新缺失被误认为原稿如此。
分区时按照阅读顺序记录页码与栏位。双栏资料不能把同一高度的左右两段直接接起来,应先确定完整段落和跨栏对象。公式单独取区,保留上下限、括号与等号两边;解释文字、题号和图注另作关联。即使最终只需要源码,也要留下这份位置清单,防止后续把识别正确的式子放进错误段落。完成质量与区域准备后,再进入数学内容的处理环节。
用四种失败表现定位回退位置
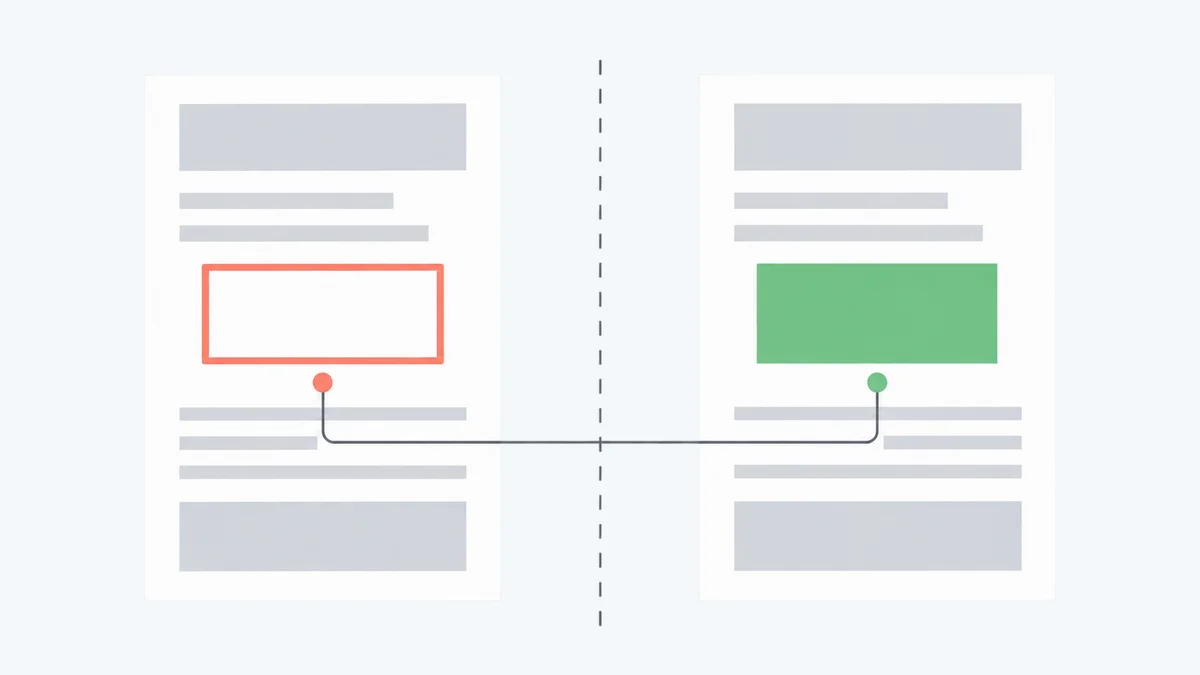
整页倾斜时,常见需要重点检查的是行列与上下位置;回到校正步骤,再确认完整边界。字迹发虚时,小字符难以区分;应查更清晰来源,而不是连续提交同一张图。双栏错序时,字符本身可能都对,问题在合并顺序,应重看区域清单。
第四类是公式被截断。若原始扫描里仍有完整内容,就扩大取区重做;若原始扫描也缺了末尾,必须回查纸本或其他副本。不能因为某条式子很常见,就把记忆中的后半段补进去。缺失情况应保持可见记录,直到找到依据后再确认完成。
逐条识别之后,带着位置记录合并
本站图片识别接受 PNG、JPG、BMP、WEBP、GIF,单张不超过 20MB。需要先从扫描文档取得公式图片,再通过“识别 → 图片识别”提交,需登录加会员。本文不将整份 PDF 当作本站直接支持的导入格式,也不把页面预处理写成本站的自动功能。
结果出现后,按原图查字符,再核对层级。例如下面的式子,积分上下限、分母和微分变量都应逐项对应原稿。
I=\int_0^1\frac{x}{1+x^2}\,dx
可在 LaTeX 模式局部修订,再切回「可视化」比较。将确认后的结果按页码和区域顺序整理,放入实际写作环境再次检查语法与内容。取得 LaTeX 文件需要在「可视化」模式导出,并满足登录与会员条件。
合并完成后再核对原页的公式数量与次序,尤其回查曾经模糊、截断或跨栏的位置。流程是否结束,应由原文与结果能够逐项对应来判断,而不是由最后一个文件是否成功保存来判断。
延伸阅读
- 扫描公式识别:逐项评估扫描质量。
- 整页论文转 LaTeX:恢复正文、图表与公式顺序。
常见问题
- 扫描件先做哪些预处理会省事?
- 先检查细节是否可辨,再校正倾斜、谨慎清理干扰并按完整区域分区。保留原始副本,处理后重新核对小数点、撇号和分数线。
- 公式被页边截断了还能补回来吗?
- 如果原始文件中也缺失内容,处理现有图片不能可靠恢复原式。应查纸本、其他清晰副本或相邻页,确认后再补录,不能凭常见公式猜。