扫描公式识别为什么更难:分辨率与倾斜
更新于
扫描公式识别出现漏指数或行列错位时,先回到扫描页本身检查。分辨率不足、纸面倾斜和旧资料噪点会分别影响字符细节、空间关系与符号判断。找到是哪一类问题,再决定重新扫描还是修整现有图,能避免把输入缺陷当成代码问题反复修改。
用细小标记判断扫描细节是否足够
打开扫描原文件,放大到可以观察下标笔画,检查小数点、撇号和根号短钩。若它们已经与纸面灰块粘在一起,后续放大只会把模糊区域变大。主标题清楚不代表公式细节足够,因为指数和下标通常更小。
能重新扫描时,在设备设置里提高采集细节,避免过度压缩,并用同一条有细小符号的表达比较调整前后结果。不要仅按文件体积判断质量:纸面空白多也会影响大小。应看最小字符是否分开、线条是否连续,再决定设置是否合适,而不是承诺某个固定参数适用于所有资料。
摆正纸张后,核对横线与行列
倾斜影响的不只是页面好不好看。上下标相对于主字符的位置、矩阵的行列关系、多行公式的对齐,都可能变得难判断。扫描前将纸张放平,检查边缘方向;书页靠近装订处时,尤其注意公式是否沿弧面变形。
已经扫描好的页,可以先在图像处理环节旋转校正,再检查四边是否仍保留全部内容。校正后不要立即贴边裁切,防止把旋转到边角的上限或括号裁掉。若整页直了但公式局部仍弯曲,说明可能是书页弧度,单纯旋转不能解决。此时能回原件就重新调整摆放,不能回原件则应标记局部待人工核对,避免给一张处理后更整齐的图过高信任。
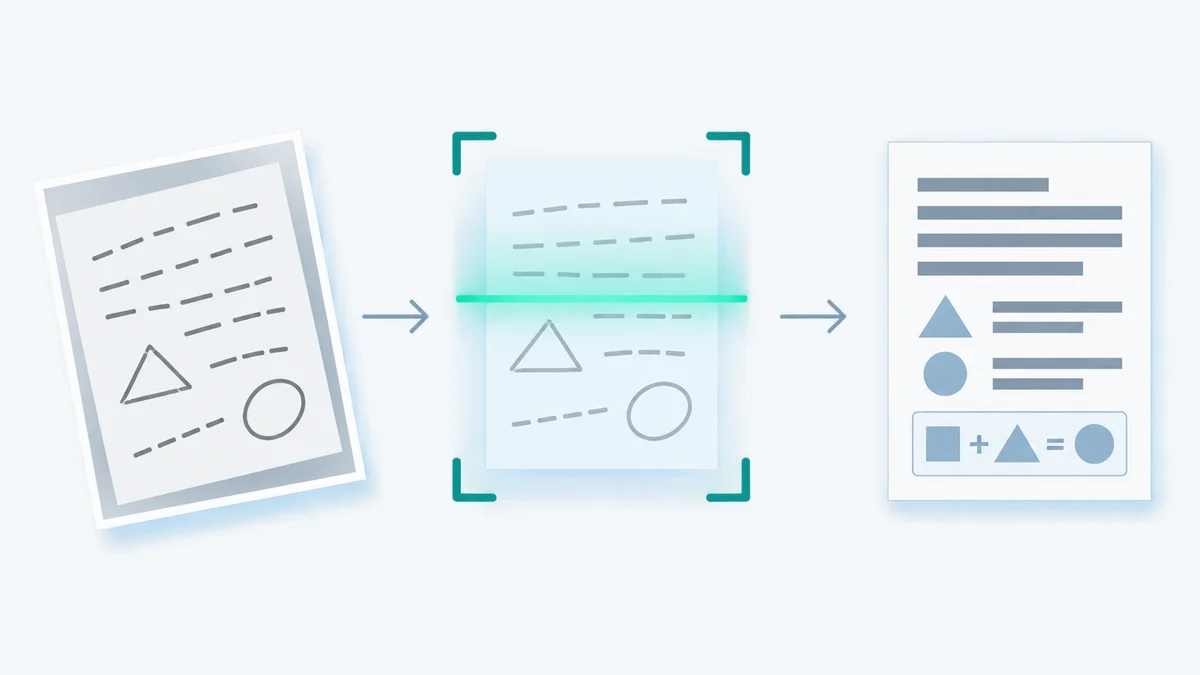
清理噪点时保留有意义的小笔画
旧纸上的墨点、透印和折痕容易靠近数学符号。处理之前保留原件副本,针对明显的背景干扰局部调整。强烈清理可能一起去掉小数点、导数撇号或细分数线,因此应把这些位置列为重点复核对象。
若有多页同源扫描,可以先挑最难的一页验证处理方式,再用于相似页面;纸色和印刷深浅不同的页仍须单独检查,不能沿用同一调整后直接接受。
例如 a=0.5 中的小数点不能按噪点抹掉;f'(x) 的短撇号也不是纸面杂线。遇到真实记号与墨点挨得很近,应通过原页上下文确认,不用“删掉后更干净”作为判断标准。清理后再与原始扫描并排检查,才能发现处理过程是否丢失内容。
无法重扫时,按可恢复程度安排补救
只有现有文件时,先校正方向,再裁取完整公式,最后检查局部干扰。顺序上先处理整页几何问题,再处理单条表达,便于避免重复裁切。若细节根本没有被记录,提升亮度和锐度都不能提供可靠原文,必须回查其他来源或手动确认。
在本站提交前,将所需区域准备为 PNG、JPG、BMP、WEBP 或 GIF,单张不超过 20MB。通过“识别 → 图片识别”处理,需登录加会员。得到结果后先比较结构,再核查扫描中最模糊的位置,不要只看清楚的大字符。
B=\begin{pmatrix}b_{11}&b_{12}\\b_{21}&b_{22}\end{pmatrix}
矩阵类材料可先数行列,再查每个下标。若只剩局部错误,可在本站编辑区修订;若同一片区域连续缺字符,应回到输入质量问题。校对后根据使用目标选择输出,并保留扫描页号与公式位置,下一次修订才有可追溯的依据。
延伸阅读
- 扫描 PDF 转 LaTeX:组织分区、识别与合并顺序。
- PDF 公式识别:判断文档中的文字层与图像层。
常见问题
- 扫描件有点歪,需要先摆正再识别吗?
- 可先在图像处理环节校正方向,并检查边缘没有被裁掉。特别是矩阵和多行推导,倾斜可能影响行列判断,摆正后仍需对照原件。
- 老资料上的墨点会被当成符号吗?
- 有可能,墨点与小数点或乘法点外形接近。清理时应对照原页逐处确认,不能一并删除所有小点,以免丢掉真实数学记号。